IA locale et documents sensibles : comment classer vos fichiers en préservant la confidentialité
Installer une IA locale pour classer des documents sensibles peut être une très bonne idée. Mais ce n’est pas une solution magique. Le vrai sujet n’est pas seulement de faire tourner un modèle sur un ordinateur : c’est de savoir où circulent les fichiers, qui peut y accéder, ce qui est conservé, comment les erreurs sont contrôlées et si le dispositif répond réellement aux contraintes de confidentialité.
Pour une entreprise, un cabinet, une association ou une équipe métier, l’objectif est souvent concret : trier des contrats, orienter des dossiers RH, identifier des pièces juridiques, résumer des documents clients ou préparer une recherche interne. Dans ces cas, une IA locale peut réduire fortement l’exposition des données à des services externes. Elle impose aussi de nouvelles responsabilités : matériel, sécurité, droits d’accès, maintenance, supervision et validation humaine.
Le vrai enjeu : classer des documents sensibles sans perdre le contrôle des données
Quand on parle d’IA locale documents sensibles, on imagine souvent une opposition simple : le cloud serait risqué, le local serait sûr. En pratique, la question est plus fine. Un document sensible peut fuir par un service cloud mal choisi, mais aussi par un poste mal protégé, un dossier partagé trop largement, un index documentaire non chiffré ou des logs qui conservent des extraits confidentiels.
Exemple simple : une équipe juridique veut classer automatiquement des contrats fournisseurs par type de clause, date d’échéance, niveau de risque et service concerné. Une IA locale peut analyser les fichiers sans les envoyer à une plateforme grand public. Mais si les résultats sont ensuite exportés dans un tableur accessible à toute l’entreprise, le risque de confidentialité n’a pas disparu : il a seulement changé de forme.
Quels documents sont concernés ?
Le recours à une IA locale devient pertinent dès que les fichiers contiennent des informations que vous ne souhaitez pas exposer à un service externe ou à des utilisateurs non autorisés. Les cas typiques incluent :
- Contrats et documents juridiques : clauses, litiges, accords de confidentialité, pièces de procédure.
- Dossiers RH : évaluations, sanctions, bulletins, candidatures, données personnelles de salariés.
- Données de santé ou médico-sociales : comptes rendus, formulaires, échanges avec des patients ou bénéficiaires.
- Documents financiers : factures, reporting, informations bancaires, prévisions, audits.
- R&D; et stratégie : brevets, feuilles de route produit, plans industriels, données de recherche.
- Fichiers clients : demandes, réclamations, historiques, pièces justificatives, données contractuelles.
- Documents soumis au secret professionnel ou au secret de fonction : selon le métier, le statut ou les obligations internes.
Ce que l’IA peut réellement faire pour le classement documentaire
Pour classer des documents avec une IA locale, il faut distinguer plusieurs tâches. L’IA ne se limite pas à “lire” un fichier : elle peut être intégrée dans une chaîne de traitement documentaire.
- Identifier le type de document : contrat, facture, courrier, CV, compte rendu, pièce administrative.
- Attribuer une catégorie métier : RH, juridique, finance, support client, conformité, R&D.;
- Extraire des métadonnées : date, nom d’organisation, échéance, référence, montant, niveau de priorité.
- Résumer le contenu pour faciliter la revue humaine, sans remplacer la lecture dans les cas sensibles.
- Détecter des signaux : clause inhabituelle, document incomplet, demande urgente, incohérence apparente.
- Orienter vers un service : envoyer un dossier au bon interlocuteur ou à la bonne file de traitement.
- Préparer une recherche interne via un index local ou une base documentaire sécurisée.
Le classement fiable repose rarement sur le modèle seul. Il faut souvent combiner extraction de texte, OCR pour les scans, règles métier, catégories prédéfinies, contrôle qualité et validation humaine.
IA locale, cloud privé, IA souveraine : ce qui change pour la confidentialité
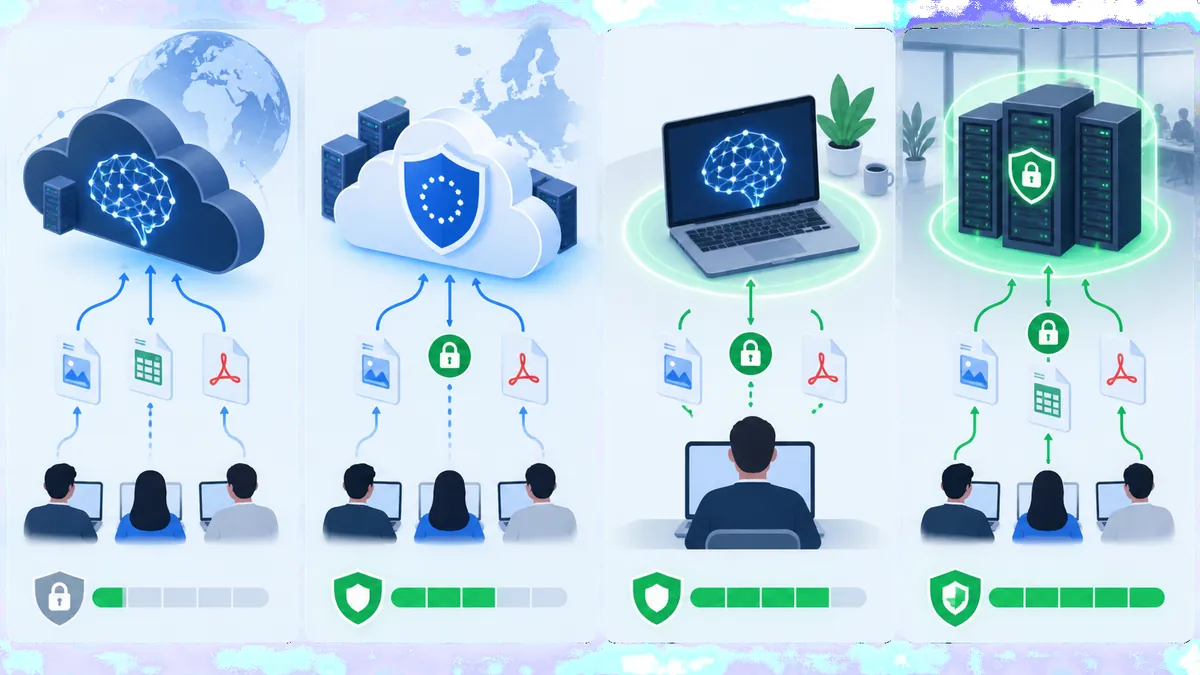
Avant de choisir un outil, il faut comprendre l’architecture. Les expressions “IA locale”, “IA souveraine”, “cloud privé” ou “instance privée” sont parfois utilisées comme si elles signifiaient la même chose. Ce n’est pas le cas.
| Option | Où sont traités les documents ? | Avantages | Points de vigilance |
|---|---|---|---|
| IA grand public cadrée | Sur les serveurs du fournisseur, selon ses conditions et paramètres | Simple, performante, rapide à tester | Transfert externe, politiques de conservation, usages interdits pour certains documents |
| Instance privée ou cloud européen | Dans un environnement dédié ou contractuellement encadré | Bon compromis entre performance, support et contrôle | Contrats, localisation, sous-traitants, configuration et audit nécessaires |
| IA locale sur poste | Sur l’ordinateur de l’utilisateur | Pas d’envoi volontaire au cloud, usage hors ligne possible | Performance limitée, sécurité du poste, absence de gouvernance centralisée |
| Serveur IA local entreprise | Sur un serveur interne ou une infrastructure maîtrisée | Contrôle, mutualisation, droits d’accès, supervision | Coût, maintenance, administration, disponibilité, sécurité réseau |
| IA souveraine entreprise | Selon l’offre : cloud localisé, fournisseur européen, infrastructure dédiée ou hybride | Meilleures garanties contractuelles et politiques selon les cas | Le mot “souverain” doit être vérifié techniquement et juridiquement |
IA grand public cadrée : suffisante pour certains usages, risquée pour d’autres
Utiliser ChatGPT, Claude, Gemini ou un autre assistant cloud avec des documents professionnels n’est pas automatiquement interdit. Pour des documents publics, déjà anonymisés ou faiblement sensibles, une charte interne, des comptes entreprise et des paramètres adaptés peuvent suffire.
Mais la requête ChatGPT documents confidentiels soulève une vraie question : avez-vous le droit, techniquement et contractuellement, de transmettre ce fichier à un service externe ? Si le document contient des données personnelles, des informations clients, des secrets d’affaires ou des données couvertes par une obligation de confidentialité, il faut vérifier les conditions d’utilisation, les options de non-entraînement, la localisation, les sous-traitants et les règles internes.
Instance privée ou cloud européen : compromis entre contrôle et performance
Une instance privée ou un cloud européen peut être plus rationnel qu’un déploiement local complet. Cette option convient souvent aux organisations qui veulent éviter les outils grand public, bénéficier de modèles puissants, conserver une administration centralisée et obtenir un cadre contractuel plus clair.
Ce n’est pas forcément “moins confidentiel” qu’un serveur interne mal administré. Tout dépend du niveau de sécurité, des engagements du fournisseur, du chiffrement, de la journalisation, de la gestion des accès, de la localisation effective des traitements et des sous-traitants impliqués.
IA locale sur poste ou serveur interne : contrôle maximal, responsabilités accrues
Une IA locale sur poste ou un serveur IA local entreprise permet de réduire les flux externes. Dans certains scénarios, l’outil peut même fonctionner sans connexion Internet. C’est particulièrement utile pour des documents soumis à des contraintes fortes ou pour des environnements isolés.
Mais ce contrôle a un prix : il faut gérer le matériel, les mises à jour, les vulnérabilités, les sauvegardes, les droits d’accès, les journaux, la supervision et la qualité des résultats. Le local ne transfère pas la responsabilité au fournisseur : il la ramène chez vous.
Quand l’IA locale est-elle le bon choix pour des documents confidentiels ?
L’IA locale est surtout intéressante quand la confidentialité et la maîtrise des flux priment sur la simplicité. Pour décider, croisez quatre critères : sensibilité des documents, volume, nombre d’utilisateurs et niveau d’exigence réglementaire ou contractuelle.
| Situation | Option souvent adaptée | Pourquoi |
|---|---|---|
| Documents publics ou déjà anonymisés | IA cloud cadrée | Le risque est limité si les règles d’usage sont claires |
| Documents internes non critiques | Cloud entreprise, instance privée ou local léger | Le choix dépend surtout du volume et des besoins de collaboration |
| Dossiers RH, contrats, fichiers clients | Instance privée, cloud européen encadré ou serveur local | Les accès, logs et garanties contractuelles deviennent essentiels |
| Secret professionnel, R&D; stratégique, documents très confidentiels | IA locale hors ligne ou serveur interne fortement sécurisé | La réduction des flux externes devient prioritaire |
| Gros volumes multi-équipes avec SLA et support | Serveur local administré ou solution clé en main | Le poste individuel ne suffit plus pour gouverner les usages |
Les situations où le local est fortement recommandé
Une IA locale hors ligne ou très verrouillée devient pertinente si vous traitez des documents que vous ne pouvez pas transférer vers un tiers, même temporairement. C’est le cas lorsque :
- un contrat interdit l’envoi à des services externes ;
- les documents relèvent du secret professionnel, du secret de fonction ou d’une obligation sectorielle forte ;
- les fichiers contiennent des données personnelles sensibles ou fortement identifiantes ;
- l’entreprise veut limiter sa dépendance à des fournisseurs externes ;
- l’environnement de travail doit fonctionner sans Internet ;
- les documents R&D; ou stratégiques représentent un avantage concurrentiel majeur.
Les situations où le local est excessif ou insuffisant
À l’inverse, installer une IA locale pour tout traiter n’est pas toujours rationnel. Le local peut être excessif pour des documents peu sensibles ou des usages ponctuels. Il peut aussi être insuffisant si vous avez besoin de très hautes performances, d’une disponibilité garantie, d’une intégration complexe avec plusieurs métiers ou d’un support contractuel fort.
Une petite équipe peut très bien commencer avec un poste local pour tester. Une organisation de 200 personnes qui veut classer des milliers de documents par semaine devra penser en termes d’architecture, de sécurité, d’administration et de gouvernance.
Poste individuel ou serveur IA local : choisir selon l’usage
Un modèle IA local LM Studio, ou un outil équivalent permettant d’exécuter un modèle sur ordinateur, peut être utile pour expérimenter, valider des prompts, tester des catégories et travailler sur un petit lot de documents. C’est simple à prendre en main, mais ce n’est pas forcément adapté à un déploiement d’entreprise.
Un serveur local devient préférable lorsque plusieurs utilisateurs doivent accéder au même service, avec des droits distincts, des journaux, un stockage centralisé, des sauvegardes, des règles de conservation et une supervision technique. Le serveur est moins “bricolage”, mais il demande des compétences d’administration.
Comment déployer une IA locale pour classer des documents sensibles
Pour installer IA locale confidentialité sans créer de nouveaux risques, il faut éviter de commencer par l’outil. Le bon ordre consiste à partir des documents, des usages et des contraintes, puis seulement à choisir le modèle et l’infrastructure.
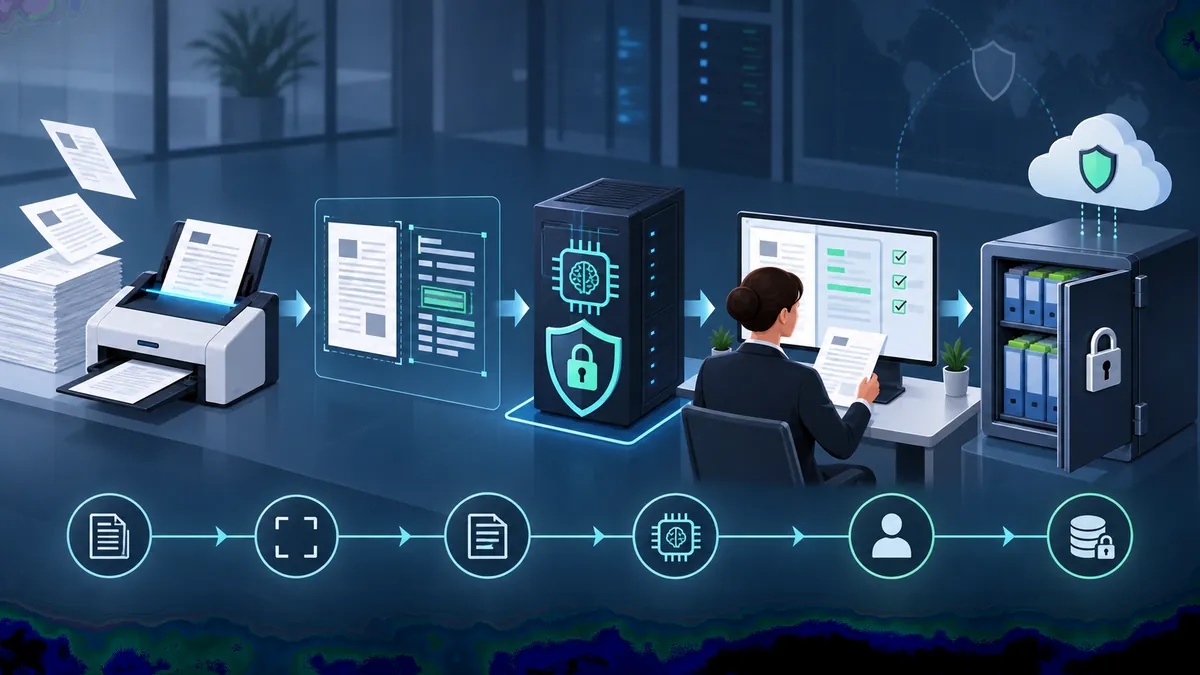
1. Cartographier les documents et définir les catégories de classement
Listez d’abord les types de documents à traiter : contrats, factures, dossiers RH, pièces clients, courriers, comptes rendus, justificatifs. Pour chaque famille, précisez :
- le niveau de confidentialité ;
- les données personnelles présentes ;
- les personnes autorisées à lire ou valider ;
- les catégories de classement attendues ;
- les exceptions et cas ambigus ;
- les règles de conservation et de suppression.
Un bon système de classement commence par une taxonomie claire. Si vos catégories métier sont floues, l’IA produira des résultats incohérents, même avec un bon modèle.
2. Choisir l’environnement : poste local, serveur interne ou solution clé en main
Pour un test, un poste local peut suffire. Il faut alors vérifier la RAM disponible, la capacité de stockage, la présence éventuelle d’un GPU, le chiffrement du disque et la possibilité de couper la connexion réseau pendant les traitements sensibles.
Pour un usage régulier, un serveur interne ou une solution clé en main devient plus robuste. Cela permet de centraliser les modèles, de gérer les accès, de contrôler les versions, de sécuriser les fichiers temporaires et d’éviter que chaque utilisateur installe son propre environnement sans gouvernance.
3. Sélectionner le modèle et régler le contexte
Le choix du modèle influence directement la qualité du classement. Un petit modèle local sera plus rapide et plus léger, mais peut être moins fiable sur des documents longs, ambigus ou très spécialisés. Un modèle plus grand demande davantage de mémoire, de puissance de calcul et parfois un matériel plus coûteux.
Sur des documents volumineux, la taille de contexte est cruciale : elle détermine la quantité de texte que le modèle peut prendre en compte à la fois. Si le contexte est trop court, il faudra découper les documents, résumer par sections ou utiliser une approche de recherche augmentée locale, souvent appelée RAG local, pour retrouver les passages pertinents.
4. Sécuriser le traitement des fichiers
La sécurité ne se limite pas à empêcher l’envoi au cloud. Pour des données sensibles IA générative, vérifiez au minimum :
- le chiffrement du disque et des sauvegardes ;
- les droits d’accès aux dossiers source, aux résultats et aux index ;
- la désactivation ou le contrôle de la télémétrie des outils utilisés ;
- le mode hors ligne lorsque le risque l’exige ;
- la suppression des fichiers temporaires après traitement ;
- la gestion des logs pour éviter d’y stocker des extraits sensibles ;
- la mise à jour régulière du système, des dépendances et des applications ;
- la séparation entre environnement de test et environnement de production.
5. Tester la qualité avant l’industrialisation
Ne déployez pas le classement automatique sur l’ensemble du fonds documentaire sans test. Constituez un jeu de documents représentatif : fichiers propres, scans de mauvaise qualité, documents longs, cas ambigus, pièces multilingues, doublons, documents incomplets.
Mesurez ensuite les erreurs : mauvaise catégorie, métadonnée absente, résumé trompeur, confusion entre deux types de documents, hallucination d’une information non présente. Pour les usages sensibles, une validation humaine reste nécessaire, au moins sur les décisions à impact ou les documents critiques.
Exemple de consigne pour classer des documents avec une IA locale
Une IA locale donne de meilleurs résultats si la consigne est structurée. Pour un usage documentaire, évitez les demandes vagues comme “classe ce document”. Préférez une instruction précise, avec catégories autorisées, format de sortie et règles d’incertitude.
Exemple de consigne adaptée à un traitement local :
Analyse le contenu du document fourni. Classe-le dans une seule des catégories suivantes : contrat fournisseur, contrat client, dossier RH, facture, courrier juridique, document financier, autre. Extrais uniquement les informations présentes dans le document : date, organisation concernée, personne concernée si visible, échéance, montant, niveau de sensibilité estimé. Si une information est absente, indique “non trouvé”. Si la catégorie est incertaine, indique “à valider humainement” et explique pourquoi en une phrase.
Ce type de consigne réduit les réponses inventées, facilite l’audit et permet d’intégrer les résultats dans un outil métier. Pour des documents très sensibles, il faut aussi décider si les réponses générées doivent être conservées, chiffrées, journalisées ou supprimées après usage.
IA locale et RGPD : ce que cela règle, et ce que cela ne règle pas
La requête IA locale RGPD revient souvent parce que le local donne une impression de conformité immédiate. En réalité, une IA locale peut aider à respecter certains principes, notamment la minimisation des transferts et le contrôle des flux. Mais elle ne garantit pas à elle seule la conformité.
Le RGPD impose une réflexion plus large : base légale, finalité, minimisation, durée de conservation, droits des personnes, sécurité, information, documentation et gestion des sous-traitants lorsqu’il y en a. Si l’IA locale traite des données personnelles, vous devez toujours savoir pourquoi vous les traitez, qui y accède, combien de temps vous les conservez et comment vous protégez les résultats.
En clair : le local réduit certains risques de transfert, mais ne remplace pas une gouvernance des données. Pour les cas complexes ou réglementés, il faut impliquer les responsables internes compétents, comme le DPO lorsqu’il existe, la sécurité informatique, le juridique ou la conformité.
Les limites techniques à anticiper
Une IA locale peut être très utile, mais elle n’a pas les mêmes capacités qu’un grand modèle cloud récent, surtout sur un poste standard. Les limites les plus fréquentes concernent la performance, la qualité d’analyse et l’intégration documentaire.
Documents longs, scans et OCR
Un modèle de langage ne lit pas directement tous les formats avec la même fiabilité. Pour des PDF scannés, il faut d’abord utiliser un OCR pour convertir l’image en texte. Si l’OCR se trompe sur un nom, une date ou un montant, l’IA peut reprendre cette erreur dans son classement.
Pour les documents longs, il faut découper le texte intelligemment, conserver les métadonnées de page, puis regrouper les résultats. Sans cette étape, le modèle peut ignorer une clause importante ou se concentrer sur le début du document.
Performance et coût matériel
L’argument “pas d’abonnement” est incomplet. Une IA locale peut coûter cher autrement : machine avec GPU, RAM, stockage rapide, sauvegardes, chiffrement, consommation électrique, temps d’administration, support, supervision et formation des utilisateurs.
Pour un usage ponctuel, le coût peut être faible. Pour un usage d’entreprise, il faut raisonner en coût total : matériel, sécurité, maintenance, disponibilité, temps humain et qualité des résultats.
Modèles moins puissants et besoin de validation
Les modèles locaux légers progressent vite, mais ils peuvent être moins performants que les meilleurs services cloud pour le raisonnement complexe, les documents multilingues, les tableaux difficiles ou les consignes très fines. La bonne approche consiste à mesurer, pas à supposer.
Dans un flux documentaire sensible, l’IA doit souvent proposer un classement, pas décider seule. La validation humaine reste indispensable pour les cas ambigus, les documents à fort impact ou les décisions susceptibles d’affecter une personne.
Les erreurs de décision les plus fréquentes
“Local” ne veut pas dire confidentialité absolue
Le local évite certains envois externes, mais il ne protège pas contre un poste infecté, un utilisateur trop curieux, un partage réseau mal configuré, une sauvegarde non chiffrée ou un index accessible à tout le monde. La confidentialité dépend de l’ensemble du dispositif.
“Open source” ne veut pas dire automatiquement plus sûr
Un modèle ou un outil ouvert peut être auditable et flexible. Cela ne garantit pas qu’il soit bien configuré, maintenu, sécurisé ou adapté à vos contraintes. À l’inverse, une solution propriétaire peut offrir un cadre contractuel solide. Le bon critère est l’adéquation au risque, pas l’étiquette.
“Hors ligne” ne veut pas dire simple à maintenir
Une IA locale hors ligne réduit les flux réseau, mais complique parfois les mises à jour, la collaboration, le support et la supervision. Il faut prévoir comment mettre à jour les modèles, corriger les failles et transférer les résultats sans créer de contournements risqués.
“Automatiser” ne veut pas dire supprimer le contrôle humain
Pour classer des documents sensibles, l’IA doit accélérer le tri, détecter des informations et préparer la décision. Elle ne doit pas devenir une boîte noire qui déplace des dossiers critiques sans traçabilité ni possibilité de correction.
Checklist avant de déployer une IA locale documentaire
Avant de passer d’un test à un usage réel, vérifiez les points suivants :
- Les catégories de documents sont définies et compréhensibles par les utilisateurs.
- Les niveaux de confidentialité sont documentés.
- Les fichiers sources, résultats, logs et index sont protégés.
- Les accès sont limités aux personnes autorisées.
- La télémétrie et les flux réseau des outils sont compris et maîtrisés.
- Le fonctionnement hors ligne est testé si nécessaire.
- Les performances sont mesurées sur un échantillon représentatif.
- Les erreurs sont suivies et corrigées.
- La validation humaine est prévue pour les cas sensibles.
- Les obligations RGPD et internes sont vérifiées avec les personnes compétentes.
- Le coût total est estimé : matériel, maintenance, sécurité, support, temps humain.
- Un plan de sauvegarde, de suppression et de mise à jour existe.
Faut-il installer soi-même ou choisir une solution clé en main ?
Installer soi-même une IA locale est pertinent pour apprendre, prototyper et évaluer la faisabilité. Un outil de type LM Studio ou équivalent peut suffire pour tester un modèle local, comparer des prompts et vérifier si le classement est prometteur sur un petit volume.
Pour un usage métier, la question change. Si plusieurs personnes doivent traiter des documents sensibles, si les volumes augmentent, si les résultats alimentent un système d’information ou si la conformité est critique, une solution administrée devient souvent plus raisonnable. Elle peut prendre la forme d’un serveur interne, d’une instance privée, d’une offre souveraine ou d’un accompagnement au déploiement.
Le bon choix n’est pas forcément le plus “local” possible. C’est celui qui offre le meilleur équilibre entre confidentialité, qualité, coût, maintenance, performance et gouvernance.
Conclusion : une excellente option, si elle est cadrée
Une IA locale peut être un levier très efficace pour classer des documents sensibles tout en limitant les transferts vers des services externes. Elle est particulièrement intéressante pour les contrats, dossiers RH, pièces juridiques, documents clients, données R&D; ou fichiers soumis à des obligations fortes de confidentialité.
Mais elle ne dispense pas d’une vraie méthode. Il faut cartographier les documents, choisir l’architecture adaptée, sécuriser les flux, tester la qualité, documenter les traitements et garder une validation humaine pour les cas critiques. En résumé : l’IA locale protège mieux certains flux, mais seule une gouvernance complète protège réellement vos documents.