Intelligence artificielle : usages concrets, outils et choix techniques
Intelligence artificielle : usages concrets, outils et choix techniques
L’intelligence artificielle n’est plus seulement un sujet de laboratoire ou de science-fiction. Elle sert déjà à rédiger des textes, détecter des fraudes, recommander des produits, assister des médecins, optimiser une chaîne logistique, répondre à des clients ou analyser de grands volumes de documents.
Mais le terme recouvre des réalités très différentes : un chatbot conversationnel, un système de recommandation, un modèle de prévision, un outil de génération d’images ou un logiciel de maintenance prédictive ne reposent pas toujours sur les mêmes techniques, les mêmes données ni les mêmes risques.
Ce guide propose une carte de décision pratique : comprendre ce qu’est l’intelligence artificielle, distinguer les grandes familles techniques, identifier les bons usages, choisir un outil adapté et contrôler les limites.
Comprendre ce que recouvre vraiment l’intelligence artificielle aujourd’hui
Définition simple : des systèmes qui apprennent, raisonnent ou assistent la décision
Si l’on se demande qu’est-ce que l’intelligence artificielle, la réponse la plus utile est la suivante : l’intelligence artificielle désigne des systèmes informatiques capables d’exécuter des tâches qui demandent habituellement des capacités humaines, comme comprendre un langage, reconnaître une image, apprendre à partir d’exemples, prévoir un résultat, raisonner sur des règles ou générer du contenu.
Une IA ne “pense” pas comme un humain. Elle applique des méthodes mathématiques, statistiques ou logiques pour produire une réponse utile dans un contexte donné. Selon les cas, elle peut :
- classer un e-mail comme prioritaire ou indésirable ;
- prévoir le risque de panne d’une machine ;
- résumer un contrat ou un rapport ;
- générer une image, un texte, du code ou une voix ;
- recommander un produit, un film ou une formation ;
- aider un professionnel à prendre une décision, sans se substituer nécessairement à lui.
La notion importante est donc moins “l’intelligence” au sens humain que la capacité à traiter des données, identifier des régularités, produire une prédiction ou assister une action.
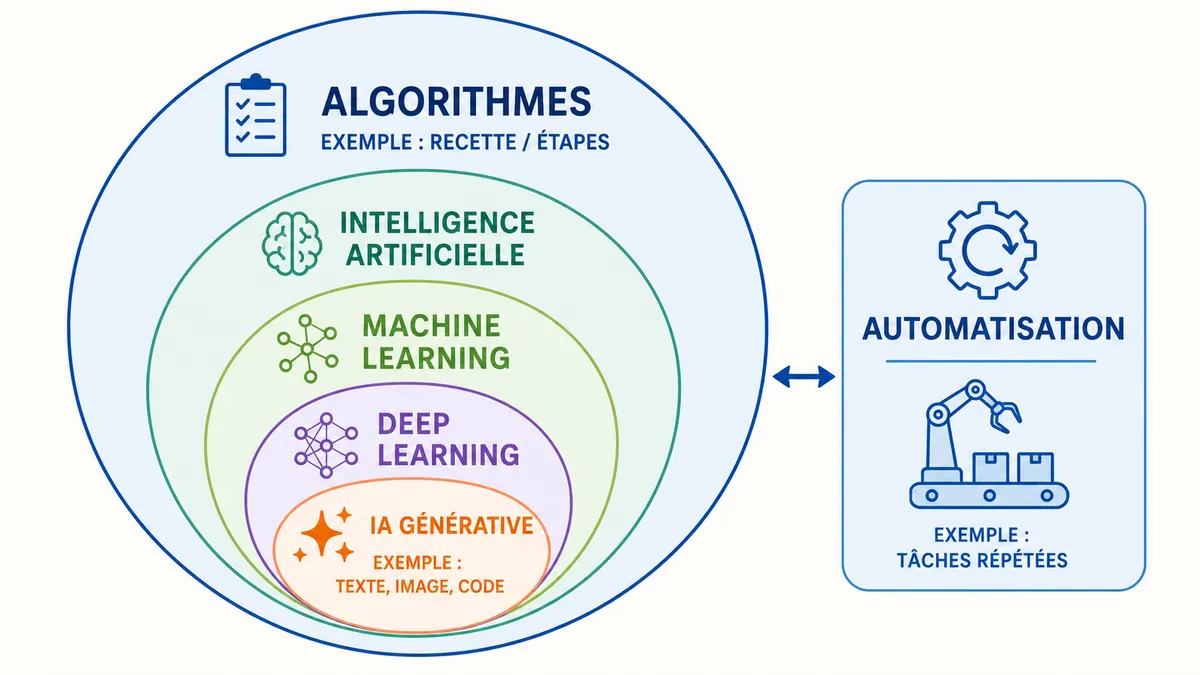
IA, automatisation, algorithme et logiciel classique : ce qui change réellement
Tous les logiciels ne sont pas des IA. Un logiciel classique suit des règles explicitement programmées : “si le client a plus de 18 ans, alors afficher telle option”. Une automatisation reproduit une suite d’actions prédéfinies : envoyer une facture, classer un fichier, déclencher un e-mail.
L’intelligence artificielle ajoute souvent une couche d’adaptation ou d’inférence. Au lieu de suivre uniquement des règles fixes, elle peut apprendre à partir d’exemples, évaluer une probabilité, interpréter un contenu non structuré ou générer une réponse nouvelle.
| Notion | Principe | Exemple | Point clé |
|---|---|---|---|
| Algorithme | Suite d’instructions pour résoudre un problème | Calculer un itinéraire | Peut exister sans IA |
| Automatisation | Exécution répétée d’une tâche définie | Envoyer une relance automatique | Suit généralement un scénario stable |
| Logiciel classique | Application de règles codées à l’avance | Calcul de paie selon des règles | Prévisible si les règles sont correctes |
| Intelligence artificielle | Analyse, apprentissage, prédiction ou génération | Détecter une fraude atypique | Peut gérer de l’incertitude et des données complexes |
La confusion vient du fait que ces éléments se combinent souvent. Un outil métier peut contenir une automatisation classique, un modèle de prédiction et une interface conversationnelle. Le bon réflexe consiste à demander : quelle décision ou quelle tâche l’IA améliore-t-elle réellement ?
IA faible, IA générative et intelligence artificielle générale : trois niveaux à ne pas confondre
La plupart des systèmes actuels relèvent de l’IA faible : ils sont performants sur des tâches précises, mais ne possèdent pas une compréhension générale du monde. Un modèle peut traduire un texte, reconnaître une tumeur sur une image médicale ou générer un résumé, sans être capable de raisonner de manière fiable dans tous les domaines.
L’IA générative désigne les systèmes capables de produire du contenu nouveau : texte, image, audio, vidéo, code informatique, présentations ou données synthétiques. Elle est devenue populaire grâce aux assistants conversationnels et aux grands modèles de langage.
L’intelligence artificielle générale, parfois appelée AGI, désigne une IA hypothétique qui pourrait comprendre, apprendre et agir de manière polyvalente au niveau humain ou au-delà dans de nombreux domaines. Elle n’existe pas aujourd’hui sous une forme opérationnelle et fiable.
Clarification utile : utiliser un chatbot très fluide ne signifie pas dialoguer avec une intelligence humaine. Un système peut produire une réponse convaincante tout en se trompant, en inventant une source ou en mal interprétant une consigne.
Les grandes familles d’IA et ce qu’elles permettent de faire
Pour choisir une solution d’IA, il faut comprendre les grandes approches disponibles. Elles ne répondent pas aux mêmes besoins et ne demandent pas les mêmes données.
Machine learning : apprendre à partir de données pour prédire ou classer
Le machine learning, ou apprentissage automatique, est une branche de l’intelligence artificielle dans laquelle un modèle apprend à partir de données plutôt que d’être programmé avec toutes les règles possibles.
Par exemple, au lieu d’écrire manuellement toutes les règles d’une fraude bancaire, on entraîne un modèle sur des transactions passées : montants, horaires, pays, appareils utilisés, historique client, signalements confirmés. Le modèle apprend ensuite à attribuer un score de risque à une nouvelle transaction.
Le machine learning est particulièrement utile pour :
- classer des demandes clients par thème ou priorité ;
- prédire des ventes, des retards ou des ruptures de stock ;
- recommander des produits ou des contenus ;
- détecter des anomalies dans des données financières, industrielles ou informatiques ;
- évaluer un risque, par exemple en assurance ou en crédit.
Son efficacité dépend fortement de la qualité des données. Des données incomplètes, biaisées ou mal étiquetées produisent des résultats fragiles.
Deep learning et réseaux de neurones : reconnaître des formes, du langage, des images ou des sons
Le deep learning, ou apprentissage profond, est une sous-famille du machine learning fondée sur des réseaux de neurones comportant de nombreuses couches de calcul. Ces modèles excellent dans le traitement de données complexes : images, voix, texte, vidéo, signaux industriels ou médicaux.
Le deep learning a permis des progrès importants dans :
- la reconnaissance d’images et la vision par ordinateur ;
- la transcription automatique de la parole ;
- la traduction automatique ;
- la détection d’objets ou de défauts dans une chaîne de production ;
- l’analyse de documents, de radiographies ou de données biomédicales.
Ces modèles peuvent être très performants, mais ils sont souvent plus difficiles à expliquer. Dans les secteurs sensibles, comme la santé, la finance ou les ressources humaines, cette opacité doit être compensée par des contrôles, des tests et une validation humaine.
IA générative et grands modèles de langage : produire, résumer, coder et dialoguer
Les grands modèles de langage, ou LLM, sont des modèles entraînés sur d’immenses volumes de textes et capables de prédire, reformuler, résumer, traduire ou générer du langage. Ils sont au cœur de nombreux assistants IA, chatbots avancés et outils d’aide à la rédaction.
Un LLM peut aider à :
- rédiger un e-mail, un article, une fiche produit ou une synthèse ;
- résumer une réunion ou un document long ;
- répondre à des questions à partir d’une base documentaire ;
- générer ou corriger du code informatique ;
- transformer un texte en plan d’action, checklist ou support de formation.
Les outils d’IA générative ne se limitent pas au texte. Ils peuvent aussi créer des images, des vidéos, des voix, de la musique ou des prototypes d’interface. Leur force est la vitesse de production ; leur limite est la fiabilité. Ils peuvent inventer des informations, reproduire des biais ou produire un contenu juridiquement risqué si les sources et les droits ne sont pas maîtrisés.
Systèmes experts, logique, optimisation et méthodes statistiques : les IA moins visibles mais très utilisées
La partie la plus visible de l’IA aujourd’hui est générative, mais de nombreuses applications reposent sur d’autres approches.
- Les systèmes experts appliquent des règles métier pour assister une décision, par exemple dans le diagnostic technique ou l’éligibilité à une aide.
- Les méthodes d’optimisation cherchent la meilleure solution parmi de nombreuses possibilités, par exemple pour planifier des tournées de livraison ou affecter des ressources.
- Les approches probabilistes gèrent l’incertitude, notamment pour évaluer un risque ou combiner plusieurs signaux imparfaits.
- Les méthodes statistiques restent essentielles pour prévoir, segmenter, détecter ou mesurer.
| Besoin | Approche IA pertinente | Exemple | Vigilance |
|---|---|---|---|
| Prévoir une demande | Machine learning, statistiques | Prévision des ventes | Données historiques fiables |
| Analyser des images | Deep learning | Contrôle qualité industriel | Jeux d’images représentatifs |
| Répondre à des questions | LLM, recherche augmentée | Assistant documentaire interne | Sources vérifiées et confidentialité |
| Planifier au mieux | Optimisation | Tournées de livraison | Contraintes métier bien modélisées |
| Appliquer des règles | Système expert | Éligibilité administrative | Mise à jour des règles |
À quoi sert l’intelligence artificielle : usages concrets par besoin
Les exemples d’intelligence artificielle sont nombreux, mais ils deviennent plus faciles à comprendre lorsqu’on les classe par besoin plutôt que par technologie.
Créer et transformer du contenu : texte, image, vidéo, audio et code
L’IA générative est devenue une porte d’entrée majeure, car elle produit des résultats immédiatement visibles. Elle peut aider un particulier, un étudiant, une équipe marketing, un développeur ou un formateur à accélérer la création de contenus.
Exemples concrets :
- transformer une prise de notes en compte rendu structuré ;
- rédiger plusieurs variantes d’un e-mail commercial ;
- créer un script vidéo à partir d’un plan ;
- générer un visuel de concept pour une campagne ;
- expliquer un morceau de code ou proposer une correction ;
- adapter un texte à un public débutant, expert ou international.
Le bénéfice principal est le gain de temps. La vigilance porte sur l’exactitude, le ton, les droits d’auteur, les données confidentielles et la nécessité de relire. Une IA peut produire une première version utile, mais rarement une version finale sans validation.
Analyser, prédire et détecter : finance, santé, industrie, logistique et cybersécurité
Dans de nombreux secteurs, l’intelligence artificielle sert moins à créer du contenu qu’à repérer des signaux difficiles à voir.
| Domaine | Usage IA | Bénéfice attendu | Vigilance |
|---|---|---|---|
| Finance | Détection de fraude, scoring, analyse de risque | Réduire les pertes et accélérer les contrôles | Équité, explicabilité, conformité |
| Santé | Aide au diagnostic, tri de documents, analyse d’imagerie | Assister les professionnels et prioriser les cas | Validation médicale, responsabilité, données sensibles |
| Industrie | Maintenance prédictive, contrôle qualité visuel | Limiter les arrêts et détecter les défauts | Capteurs fiables, faux positifs, sécurité |
| Logistique | Prévision de demande, optimisation des stocks et tournées | Réduire les coûts et améliorer les délais | Données temps réel et contraintes terrain |
| Cybersécurité | Détection d’anomalies, classification d’alertes | Réagir plus vite aux menaces | Attaques adversariales, surcharge d’alertes |
Dans ces usages, le résultat doit être mesuré : taux de détection, faux positifs, erreurs évitées, temps de traitement, coût de maintenance, qualité de service ou satisfaction utilisateur.
Assister les métiers : support client, droit, RH, formation, recherche et administration
L’intelligence artificielle en entreprise prend souvent la forme d’un copilote métier. Elle ne remplace pas forcément un professionnel, mais l’aide à traiter plus vite l’information, à produire une première analyse ou à standardiser certaines tâches.
Quelques cas fréquents :
- Support client : suggérer des réponses, classer les demandes, détecter les urgences, alimenter une base de connaissance.
- Droit : rechercher des clauses, comparer des versions de contrats, préparer une synthèse, repérer des risques documentaires.
- Ressources humaines : structurer des fiches de poste, analyser des besoins de formation, préparer des entretiens, sans automatiser aveuglément les décisions sensibles.
- Formation : créer des quiz, adapter un contenu au niveau de l’apprenant, générer des exercices.
- Recherche : résumer des publications, extraire des concepts, cartographier des controverses.
- Administration : orienter les usagers, préremplir des formulaires, classer des dossiers, aider au traitement documentaire.
Le point critique est la responsabilité : plus l’usage touche à des droits, à la santé, à l’emploi, à la sécurité ou à une décision importante, plus la validation humaine et la traçabilité sont indispensables.
Personnaliser l’expérience : recommandations, moteurs de recherche et services numériques
Une grande partie de l’IA du quotidien est invisible. Elle intervient dans les moteurs de recherche, les plateformes de vidéo, les sites e-commerce, les applications de navigation, les correcteurs orthographiques, les filtres anti-spam ou les assistants vocaux.
Ces systèmes personnalisent les résultats selon un contexte : historique, préférences, localisation, comportement, similarité avec d’autres utilisateurs ou contenu consulté. Le bénéfice est évident : trouver plus vite une information ou un produit pertinent. Le risque est aussi connu : enfermer l’utilisateur dans des recommandations répétitives, amplifier certains contenus ou collecter trop de données personnelles.
Choisir une approche ou un outil IA selon son objectif
Les outils intelligence artificielle sont nombreux : assistants conversationnels, générateurs d’images, plateformes d’automatisation, API de modèles, solutions métier, modèles open source, outils d’analyse documentaire ou copilotes intégrés aux logiciels existants. Le bon choix ne commence pas par l’outil, mais par le problème.
Partir du problème à résoudre plutôt que de l’outil à tester
Avant de tester une solution IA, formulez le besoin de manière mesurable :
- gagner 30 % de temps sur la rédaction de comptes rendus ;
- réduire les erreurs de saisie dans un processus administratif ;
- identifier plus vite les demandes clients urgentes ;
- améliorer la qualité des prévisions de stock ;
- rendre une base documentaire interne plus accessible ;
- automatiser une tâche répétitive sans dégrader la qualité.
Un bon cas d’usage IA possède trois caractéristiques : une tâche fréquente, une valeur claire et un risque contrôlable. À l’inverse, un projet flou comme “mettre de l’IA partout” produit souvent des démonstrations séduisantes mais peu utiles.
Données, confidentialité, coût et intégration : les critères qui changent tout
Le choix d’un outil dépend de critères pratiques, pas seulement de ses performances annoncées.
- Données nécessaires : l’outil fonctionne-t-il avec vos données ? Sont-elles propres, accessibles, représentatives et légalement utilisables ?
- Confidentialité : les données envoyées à l’outil sont-elles stockées, réutilisées pour l’entraînement ou traitées hors de votre environnement ?
- Qualité : comment mesurez-vous la pertinence, les erreurs, les hallucinations ou les biais ?
- Coût : abonnement, coût par requête, hébergement, intégration, formation, maintenance.
- Intégration : l’outil se connecte-t-il à vos logiciels, documents, bases de données et processus existants ?
- Contrôle humain : qui valide, corrige, supervise et assume la décision finale ?
- Réversibilité : pouvez-vous changer de fournisseur ou récupérer vos données facilement ?
Chatbot, copilote, API, modèle open source ou solution métier : quelle option pour quel cas ?
| Option | Quand l’utiliser | Avantage | Limite |
|---|---|---|---|
| Chatbot généraliste | Idéation, rédaction, synthèse, aide ponctuelle | Rapide à tester | Peu adapté aux données sensibles ou aux processus critiques |
| Copilote intégré | Productivité bureautique, code, CRM, support | Intégré aux outils quotidiens | Dépendance à l’écosystème fournisseur |
| API de modèle IA | Créer une application ou automatiser un flux | Flexible et industrialisable | Demande des compétences techniques |
| Modèle open source | Contrôle, personnalisation, hébergement interne | Maîtrise et souveraineté possibles | Infrastructure et expertise nécessaires |
| Solution métier | Cas spécialisé : juridique, santé, finance, RH, industrie | Fonctions adaptées au domaine | Moins flexible et parfois coûteuse |
Exemple avant/après : transformer un processus métier avec l’IA
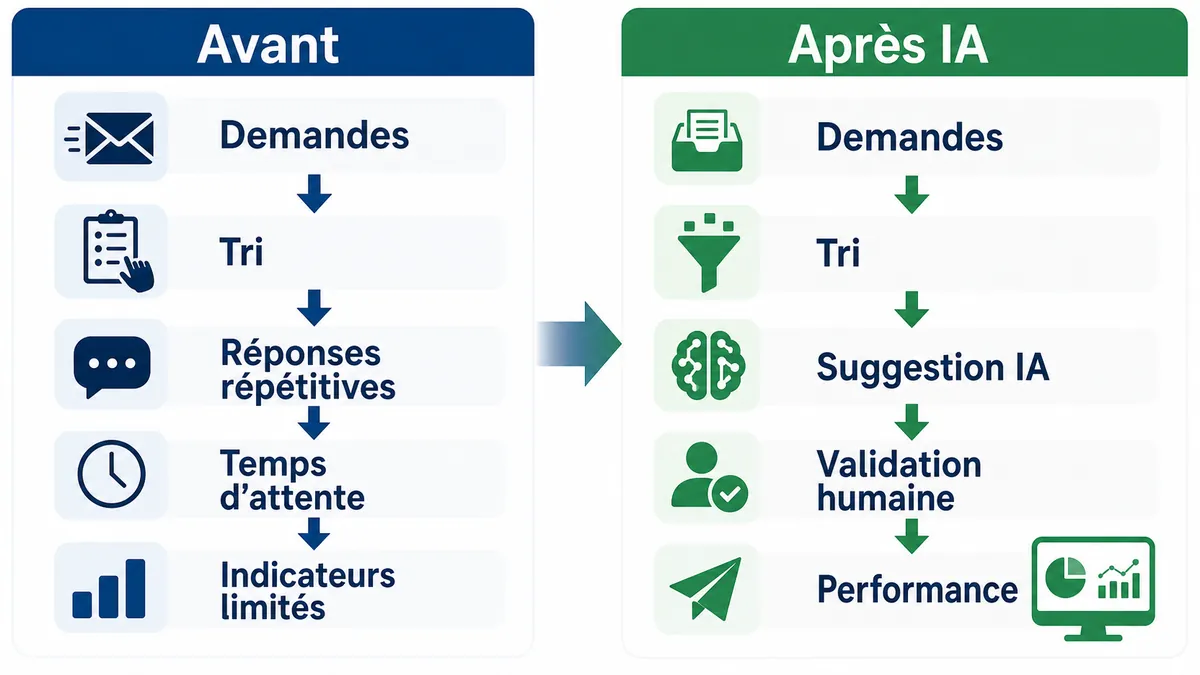
Prenons un service client qui reçoit 1 000 demandes par semaine.
Avant : les agents lisent chaque message, identifient le thème, cherchent une réponse dans la documentation, rédigent une réponse, puis escaladent les cas complexes. Le délai varie selon la charge et les réponses peuvent manquer d’homogénéité.
Avec IA : un modèle classe les demandes, détecte les urgences, suggère une réponse à partir de la base de connaissance et propose un niveau de confiance. L’agent conserve la validation finale. Les cas sensibles sont automatiquement orientés vers un humain expérimenté.
Indicateurs à suivre : temps moyen de réponse, taux de résolution au premier contact, taux d’erreur, satisfaction client, nombre d’escalades, qualité des réponses, coût par demande.
Le succès ne vient pas seulement du modèle. Il dépend de la qualité de la base documentaire, de la formation des agents, des règles d’escalade et du suivi continu des erreurs.
Mettre en place l’IA sans brûler les étapes
Identifier un cas d’usage à faible risque mais à forte valeur
Pour démarrer, mieux vaut éviter les projets trop critiques. Un bon premier projet d’IA doit permettre d’apprendre vite sans exposer l’organisation à un risque majeur.
Exemples de premiers cas pertinents :
- résumer des réunions internes non sensibles ;
- classer des demandes entrantes ;
- générer des brouillons de contenus relus par un humain ;
- créer une FAQ interne à partir de documents validés ;
- analyser des retours clients pour identifier des thèmes récurrents.
Évitez au départ les usages impliquant une décision automatique sur une personne, des données de santé, des données très confidentielles ou des conséquences juridiques fortes, sauf si le cadre de conformité est déjà solide.
Tester sur un périmètre limité, mesurer puis améliorer
Un déploiement réussi suit souvent une logique d’expérimentation :
- Définir le problème : tâche concernée, utilisateurs, volume, irritants actuels.
- Choisir un périmètre pilote : une équipe, un type de document, un canal, une période limitée.
- Établir des critères de succès : temps gagné, qualité, coût, satisfaction, erreurs acceptables.
- Tester plusieurs approches : outil existant, API, solution métier, automatisation simple.
- Mesurer les résultats : comparer avant/après avec des données réelles.
- Corriger et documenter : ajuster les prompts, les règles, les données, les contrôles.
- Décider du passage à l’échelle : seulement si le bénéfice est prouvé et les risques maîtrisés.
Former les utilisateurs : prompts, esprit critique et validation humaine
La formation intelligence artificielle ne doit pas se limiter à apprendre quelques prompts. Les utilisateurs doivent comprendre ce que l’outil sait faire, ce qu’il ne sait pas faire et quand il faut vérifier.
Les compétences utiles incluent :
- formuler une consigne claire avec le contexte, l’objectif, le format attendu et les contraintes ;
- demander des sources ou des justifications lorsque c’est pertinent ;
- comparer plusieurs réponses au lieu d’accepter la première ;
- repérer les formulations plausibles mais non vérifiées ;
- protéger les données sensibles ;
- savoir quand l’usage de l’IA est inadapté.
Un principe simple : plus la conséquence d’une erreur est importante, plus la validation humaine doit être forte.
Prévoir la gouvernance : responsabilités, données, sécurité et documentation
Dans une organisation, l’IA doit être gouvernée comme un système à risque variable. Cela implique de définir qui a le droit d’utiliser quels outils, avec quelles données, pour quels usages et sous quelle supervision.
Une gouvernance minimale doit couvrir :
- la liste des usages autorisés, tolérés ou interdits ;
- les règles de traitement des données personnelles et confidentielles ;
- les responsabilités en cas d’erreur ou de décision assistée ;
- la documentation des modèles, données, prompts et paramètres importants ;
- les tests de biais, de sécurité et de robustesse ;
- les procédures de contrôle humain et d’audit.
Limites, risques et débats : ce qu’il faut contrôler avant de faire confiance à l’IA
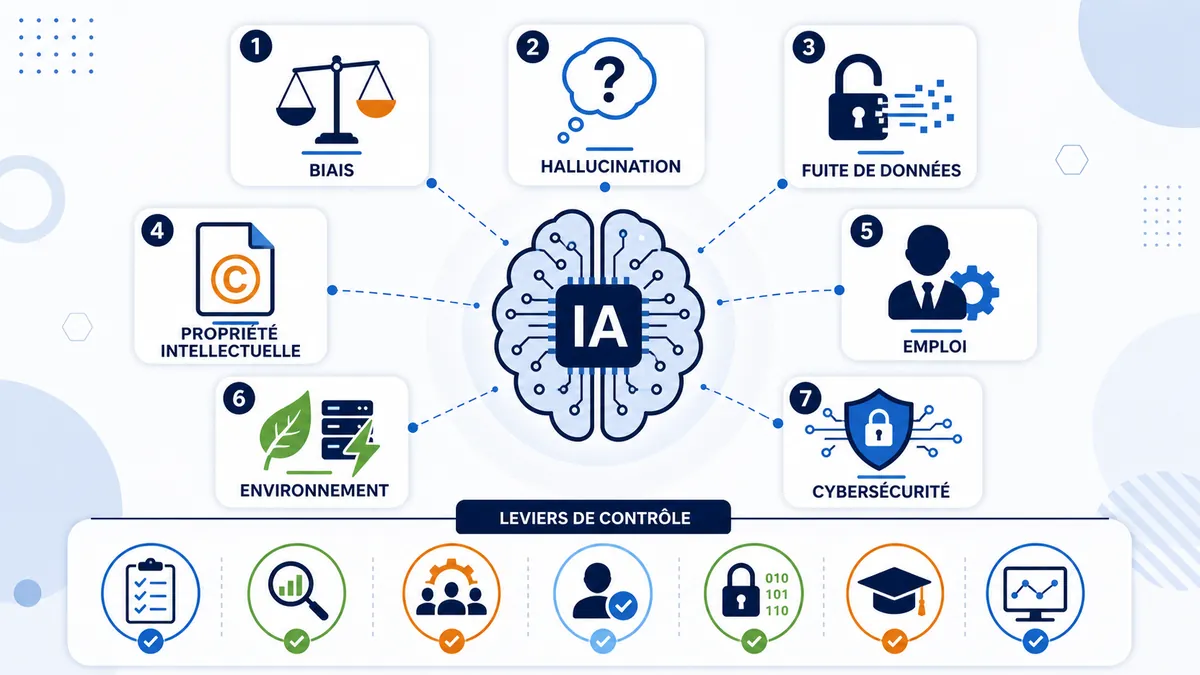
Les risques de l’intelligence artificielle ne doivent pas être traités comme un sujet séparé. Ils dépendent du cas d’usage, des données, du modèle, du niveau d’automatisation et des conséquences possibles.
Biais, hallucinations et erreurs : pourquoi une réponse plausible peut être fausse
Un modèle d’IA peut produire une réponse convaincante mais incorrecte. Dans le cas des LLM, on parle souvent d’hallucination lorsqu’un modèle invente une information, une référence, un chiffre ou une explication.
Les biais peuvent apparaître lorsque les données d’entraînement reflètent des inégalités, des stéréotypes ou des déséquilibres. Un système de recrutement, de scoring ou de modération peut alors défavoriser certains groupes sans intention explicite.
Contrôles utiles :
- tester le système sur des cas variés et représentatifs ;
- mesurer les erreurs par catégorie d’utilisateur, de document ou de situation ;
- exiger des sources pour les réponses factuelles ;
- interdire les décisions entièrement automatisées dans les cas sensibles ;
- mettre en place un canal de signalement et de correction.
Données personnelles, propriété intellectuelle et sécurité
Les données sont au cœur de l’IA. Elles sont aussi au cœur des risques. Envoyer un contrat confidentiel, un fichier client, un code propriétaire ou un dossier RH dans un outil non maîtrisé peut créer une fuite d’information.
Les principaux points de vigilance sont :
- Données personnelles : base légale, minimisation, durée de conservation, droits des personnes, sécurité.
- Confidentialité : secrets d’affaires, données clients, informations internes, documents stratégiques.
- Propriété intellectuelle : droits sur les contenus d’entrée, droits sur les contenus générés, risque de reproduction involontaire.
- Sécurité : prompt injection, extraction de données, détournement d’un chatbot, génération de code vulnérable.
Une règle pratique : ne saisissez pas dans un outil public une information que vous n’enverriez pas à un prestataire externe sans contrat ni vérification.
Emploi, compétences et organisation du travail
Le lien entre IA et emploi est souvent présenté de manière excessive, soit comme une destruction massive, soit comme une simple amélioration de productivité. La réalité est plus nuancée.
L’IA automatise certaines tâches, transforme des métiers et crée de nouveaux besoins. Les tâches répétitives, documentaires, analytiques ou rédactionnelles sont particulièrement concernées. Mais dans de nombreux cas, l’enjeu est l’augmentation du travail humain : gagner du temps sur les tâches à faible valeur pour se concentrer sur la relation, la décision, la créativité, le contrôle ou l’expertise.
Les organisations doivent anticiper :
- la montée en compétence des équipes ;
- la redéfinition de certaines tâches ;
- l’accompagnement des métiers exposés ;
- la transparence sur les usages de l’IA ;
- la prévention d’une surveillance excessive ou d’une intensification du travail.
Impact environnemental, usages malveillants et gouvernance
L’entraînement et l’utilisation de grands modèles peuvent consommer beaucoup d’énergie, d’eau et de ressources informatiques. L’impact dépend de la taille du modèle, de l’infrastructure, du volume de requêtes et du mode d’hébergement.
Pour réduire l’impact environnemental, il est possible de :
- choisir un modèle proportionné au besoin plutôt que le plus puissant disponible ;
- réutiliser des modèles existants au lieu d’en entraîner de nouveaux ;
- optimiser les requêtes et éviter les traitements inutiles ;
- mesurer les coûts informatiques dans les projets à grande échelle ;
- sélectionner des fournisseurs transparents sur leur infrastructure.
Les usages malveillants existent également : hameçonnage plus convaincant, deepfakes, désinformation, automatisation d’attaques, génération de faux documents. La réponse passe par la détection, la sensibilisation, la traçabilité et des règles claires d’usage.
Réglementation et conformité : ce que change l’encadrement de l’IA
La réglementation intelligence artificielle se renforce, notamment en Europe avec l’AI Act. L’objectif est d’encadrer les systèmes selon leur niveau de risque, d’imposer davantage de transparence et de responsabiliser les fournisseurs comme les utilisateurs professionnels.
Sans entrer dans un avis juridique, les grands principes à retenir sont :
- certains usages sont interdits ou fortement restreints lorsqu’ils portent atteinte aux droits fondamentaux ;
- les systèmes à haut risque doivent respecter des exigences renforcées de documentation, gestion des risques, qualité des données, supervision humaine et robustesse ;
- les utilisateurs doivent être informés lorsqu’ils interagissent avec une IA dans certains contextes ;
- les contenus générés ou manipulés artificiellement peuvent nécessiter une signalisation ;
- les organisations doivent documenter leurs usages, leurs fournisseurs, leurs contrôles et leurs responsabilités.
Pour une entreprise, la conformité ne doit pas arriver après le déploiement. Elle doit être intégrée dès la sélection du cas d’usage, du fournisseur, des données et du niveau d’automatisation.
| Risque | Exemple | Contrôle recommandé |
|---|---|---|
| Hallucination | Référence juridique inventée | Vérification humaine et sources obligatoires |
| Biais | Scoring défavorable à certains profils | Tests d’équité et audit régulier |
| Fuite de données | Document confidentiel saisi dans un outil public | Politique d’usage et outils validés |
| Erreur métier | Mauvaise recommandation médicale ou financière | Supervision par un expert qualifié |
| Non-conformité | Décision automatisée non documentée | Analyse de risque et documentation |
Synthèse : comment se repérer dans l’IA et continuer à apprendre
La carte rapide : besoin, technologie, exemple et point de vigilance
Pour retenir l’essentiel, partez toujours du besoin. La technologie vient ensuite.
| Besoin | Technologie possible | Exemple concret | Point de vigilance |
|---|---|---|---|
| Créer du contenu | IA générative, LLM, modèles image/audio/vidéo | Rédiger une synthèse ou générer un visuel | Exactitude, droits, validation |
| Répondre à des questions internes | LLM avec recherche documentaire | Assistant sur base de connaissance | Sources, confidentialité, hallucinations |
| Prévoir un résultat | Machine learning, statistiques | Prévision de ventes ou de pannes | Données historiques fiables |
| Reconnaître des images ou sons | Deep learning | Contrôle qualité ou transcription vocale | Représentativité des données |
| Optimiser une organisation | Optimisation, recherche opérationnelle | Planification de tournées | Contraintes métier réelles |
| Assister une décision sensible | IA spécialisée, système expert, scoring | Aide au tri de dossiers | Explicabilité, supervision, conformité |
Questions à se poser avant d’utiliser une solution d’intelligence artificielle
- Quel problème précis l’IA doit-elle résoudre ?
- Le résultat attendu est-il mesurable ?
- Les données nécessaires sont-elles disponibles, fiables et utilisables légalement ?
- Quel est le risque si l’IA se trompe ?
- Un humain valide-t-il les résultats importants ?
- Les utilisateurs savent-ils interpréter et contester la réponse ?
- Les données saisies sont-elles confidentielles ou personnelles ?
- L’outil respecte-t-il vos exigences de sécurité, de conformité et de localisation des données ?
- Le coût total inclut-il l’intégration, la formation, la maintenance et les contrôles ?
- Existe-t-il une solution plus simple qu’une IA pour le même problème ?
Ressources à approfondir : IA générative, machine learning, prompts, outils et réglementation
Pour progresser, il est utile de structurer l’apprentissage par niveau :
- Compréhension générale : vocabulaire de l’IA, différences entre machine learning, deep learning, LLM et automatisation.
- Usage personnel et professionnel : prompts, assistants IA, recherche documentaire, génération de contenu, vérification des réponses.
- Déploiement en entreprise : choix d’outils, intégration, gouvernance, mesure de performance, sécurité.
- Aspects techniques : données, modèles, API, modèles open source, évaluation, architecture logicielle.
- Cadre éthique et réglementaire : biais, transparence, protection des données, AI Act, responsabilité.
L’intelligence artificielle est un levier puissant lorsqu’elle est reliée à un besoin réel, alimentée par des données maîtrisées et encadrée par des contrôles adaptés. La bonne question n’est donc pas “faut-il utiliser l’IA ?”, mais plutôt : pour quel usage, avec quel niveau de risque, quelle preuve de valeur et quelle responsabilité humaine ?
Dernières publications
- IA locale et documents sensibles : comment classer vos fichiers en préservant la confidentialité
- Modèles IA open source chinois : ce qu’ils changent vraiment pour les outils IA européens
- Créer une veille avec l’IA sans se noyer dans les alertes
- IA chinoise : les tendances à surveiller et ce qu’elles changent vraiment pour la veille IA
- Actualité de l’intelligence artificielle : comment suivre l’IA sans tomber dans la hype
- IA locale ou cloud : comment choisir la bonne approche pour votre entreprise ?